ZPL imprime caracteres acentuados incorrectamente
Los caracteres acentuados se imprimen incorrectamente en ZPL cuando los bytes que envía y el conjunto de caracteres que la impresora espera no coinciden. Guarde el ZPL como UTF-8, coloque ^CI28 después de ^XA, y use una fuente que tenga los glifos; ^CI28 por sí solo no añade caracteres que le falten a una fuente.
Actualizado 2026-10-20 · Renderizados hechos con el motor de OpenZPL
Abrir en el visorLo que ve
En la impresora, Café Müller aparece como Café Müller, como Caf? M?ller, o con espacios donde deberían estar las letras acentuadas. El resto de la etiqueta está bien.
Por qué sucede
Un archivo ZPL es un flujo de bytes. La impresora convierte esos bytes en caracteres con el conjunto de caracteres elegido por ^CI. El valor por defecto, ^CI0, lee un byte por carácter. UTF-8, que casi todos los editores y lenguajes de programación utilizan hoy, guarda é como dos bytes. Al leer un byte a la vez, esos dos bytes se convierten en dos caracteres incorrectos.
| Lo que envía | Bytes para é | Impresora en ^CI0 | Impresora en ^CI28 |
|---|---|---|---|
| Texto UTF-8 (la mayoría de editores, Python, Node) | C3 A9 | é | é |
| Texto Windows-1252 / Latin-1 | E9 | é | un espacio o un carácter de reemplazo |
Por lo tanto, hay tres posibles causas, y la primera columna de la tabla las distingue:
- Bytes UTF-8 sin
^CI28. El caso más común: dos caracteres incorrectos por acento. - Bytes Latin-1 con
^CI28. El archivo fue guardado por un sistema antiguo en Windows-1252, pero la etiqueta declara UTF-8. Las letras acentuadas desaparecen. - La fuente no tiene glifo para el carácter. La codificación es correcta, pero la fuente no puede dibujarlo. Este es el problema habitual con texto cirílico, griego, árabe o CJK.
La solución
Envía UTF-8 y díselo. Coloca ^CI28 una vez, justo después de ^XA, y mantenlo en cada etiqueta del archivo:
^XA
^CI28
^FO40,40^A0N,50,50^FDCafé Müller, Ñandú^FS
^XZ
Si el ZPL proviene de una base de datos o de una exportación de ERP, verifica la codificación en el punto donde escribes el archivo o el cuerpo HTTP. En Python, zpl.encode("utf-8"); en Node, un cuerpo de cadena se envía como UTF-8 por fetch. Si no puedes cambiar la codificación de la fuente, utiliza el conjunto de caracteres que coincida en lugar de ^CI28, por ejemplo ^CI27 para Windows-1252, y prueba en tu impresora.
Cuando la fuente es el problema
^CI28 decide cómo los bytes se convierten en caracteres, no qué caracteres puede dibujar una fuente. La misma etiqueta con texto en japonés dibuja las letras latinas y deja espacios en blanco para el resto:
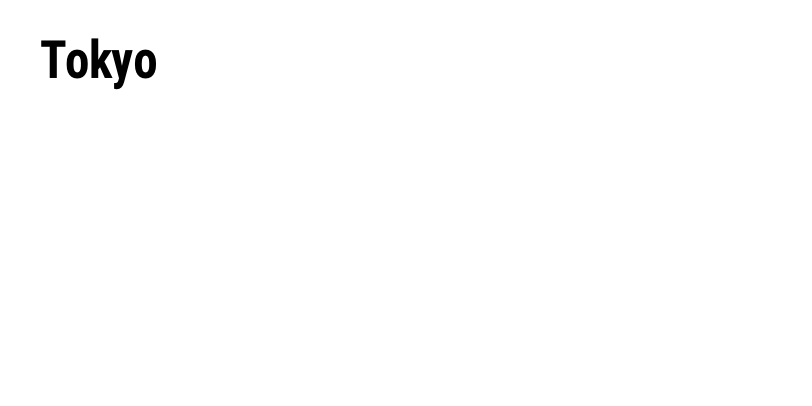
^XA
^CI28
^FO40,40^A0N,50,50^FDTokyo 東京^FS
^XZ
En una impresora Zebra, la solución es una fuente que cubra el script, descargada a la impresora y seleccionada con ^A@ o mapeada con ^CW. Qué fuentes están instaladas depende del modelo de la impresora y del firmware, así que verifique la lista de fuentes de la impresora (^WD) antes de diseñar la etiqueta.
^CI28. No tome una vista previa correcta como prueba de que la impresora lo imprimirá: añada ^CI28 de todos modos.Cómo verificar
- Abra el archivo en un visor hexadecimal, o en el visor ZPL, y mire los bytes de una letra acentuada:
C3 A9es UTF-8,E9es Latin-1. - Imprima una etiqueta de prueba con una línea de cada carácter acentuado que use.
- Si solo algunos caracteres fallan, es la fuente; si todos fallan de la misma manera, es la codificación.
Preguntas
¿Dónde va ^CI28 en la etiqueta?
Justo después de ^XA, antes del primer campo. Permanece en efecto hasta que haya otro ^CI, pero colóquelo en cada etiqueta de un archivo para que una etiqueta enviada por sí sola aún funcione.
¿Necesito ^FH para imprimir acentos?
No. ^FH le permite escribir bytes como hexadecimales, por ejemplo _C3_A9 para é en UTF-8. Ayuda cuando su sistema no puede enviar el carácter en sí, pero con UTF-8 y ^CI28 puede escribir é directamente.